Hejto.pl
Dodaj post

Wpisz coś do wyszukania (minimum 2 znaki)

#chatgpt

Gwiazdor

w AI

2piorunów

The Australian donosi "ChatGPT wynalazł szczepionkę na raka dla umierającego psa": https://www.theaustralian.com.au/business/technology/tech-boss-uses-ai-and-chatgpt-to-create-cancer-vaccine-for-his-dying-dog/news-story/292a21bcbe93efa17810bfcfcdfadbf7

No i mam wrażenie, że nie tędy droga, a artykuł ukazuje jak w soczewce problemy z wykorzystaniem i opisywaniem nowych technologii.

Po pierwsze, pies, według artykułu, był poddany konwencjonalnemu leczeniu - chemio- i radioterapii. Nie mamy pewności, że to właśnie te metody leczenia nie zadziałały z opóźnieniem, a artykuł o tym wspomina - jakby z obowiązku - jednym zdaniem.

Po drugie, artykuł wspomina o problemach z regulacjami. No szczerze, to jakbym był w komisji etyki i dostał badanie "podamy psu szczepionkę mRNA dedykowaną dla tego psa a z mRNA wygenerowanym ChatemGPT; nie, główny pomysłodawca nie ma pojęcia o biologii" to też bym żądał więcej informacji zamiast podpisać w ciemno.

Po trzecie, artykuł pyta:

“It raises the question, if we can do this for a dog, why aren’t we rolling this out to all humans with cancer? It gives hope to a lot of people, and it’s something we’re passionate about trying to chase up here.’’.

No właśnie nie możemy dlatego, że trzeba udowodnić, że technologia medyczna działa przed jej zastosowaniem, a przypadek jednego psa (leczonego równolegle metodami konwencjonalnymi) to za mało na dowód.

W 2021 rozpisywano się o leku na Alzheimera - pod nazwą Aduhelm - który nawet przeszedł badania kliniczne, został dopuszczony do obrotu w USA i okazał się skuteczny u niektórych osób. W dniu jego dopuszczenia trzech doradców FDA złożyło jednak rezygnację - problem w tym, że częściej niż wywoływać remisję w chorobie Alzheimera powodował obrzęk mózgu.

No ale na podstawie tego artykułu dostałem już od znajomego że "WIDZISZ CHATGPT RATUJE ŻYCIE A TY JESTEŚ TAK BARDZO NA NIE".

Piszę to, bo jednak chciałbym poznać inne punkty widzenia, więc zapraszam do dyskusji, może faktycznie mam skrzywienie anty-LLMowe

Jak zawsze nie wiem, jak to otagować, spróbuję

Pokaż więcej komentarzy (4)

GURU

w Hydepark

4piorunów

Stworzylem przy pomocy takie arcydziela
Czy zasluguje na plusa?
edit: dodatkowo chat sam mi zaproponowal dwie wersje

Pokaż więcej komentarzy (7)

Mocarz

w Technologia

6piorunów

ChatGPT z Shazamem: Muzyczna rewolucja w Twoim czacie

:face_with_cowboy_hat: ChatGPT dostał uszy. Integracja z Shazamem to funkcja, na którą nie wiedziałeś(aś), że czekasz Każdemu z nas zdarzyło się to dziesiątki razy. Jesteś w kawiarni, oglądasz film, scrollujesz media społecznościowe i nagle słyszysz utwór, który wwierca się w

Mocarz

w Wiadomości Świat

6piorunów

Dlaczego czaty LLM nie grupują automatycznie historii rozmów w kategorie?

Przy większej liczbie czatów ciężko się w tym połapać, a wyszukiwarki w takich aplikacjach zwykle działają przeciętnie.

Pokaż więcej komentarzy (5)

Osobistość

w Dyskusje

2piorunów

GPT-5.4 wyszło. Lecą z tymi numerkami.

https://openai.com/index/introducing-gpt-5-4/

Osobistość0piorunów

Bardzo ciekawe.

Btw,

https://www.youtube.com/watch?v=EV7WhVT270Q

Tu jest dlaczego tak szybko są nowe cyferki.

Tldr, inaczej się teraz trenuje. Nacisk przeszedł z 1h szej fazy treningu na drugą i trzecią, bo za dużo pierwszej daje bardzo drogi w użyciu model, z którego i tak nie wydobędziesz wszystkiego bez dobrej drugiej i trzeciej fazy.

No i można model wypuścić już przy skróconej drugiej i 3. fazie, a potem pociągnąć drugą i trzecią dłużej. Albo ten sam model po pierwszej przetworzyć zmienioną drugą i trzecią. Wszytko dużo taniej niż robić pierwszą od nowa.

State of AI in 2026: LLMs, Coding, Scaling Laws, China, Agents, GPUs, AGI | Lex Fridman Podcast #490Auf YouTube findest du die angesagtesten Videos und Tracks. Außerdem kannst du eigene Inhalte hochladen und mit Freunden oder gleich der ganzen Welt teilen.YouTube

Gruba ryba

w Hydepark

13piorunów

Rozwalają mnie ludzie, którzy teraz masowo uciekają od OpenAI i przenoszą się do Anthropic z powodów etycznych.

No tak, w końcu Anthropic ma swój slogan "Bezpieczeństwo ponad pieniędzmi", prawda?

No może i prawda, ale prawdą jest też to, że w ubiegłym tygodniu wycofali się z własnej klauzuli bezpieczeństwa, mówiącej, że nie będą się brali za rozwiązania AI, dopóki nie zapewnią dla nich środków bezpieczeństwa.

A wiecie, czemu się z tego wycofali? Bo, w skrócie, nie ma to sensu w momencie kiedy inni takiego zabezpieczenia nie stosują. To tyle z tego, jak mocno Anthropic trzyma się etyki. Pozostaje czekać, kiedy uznają, że skoro OpenAI współpracuje z Pentagonem, to ich decyzja nic nie zmienia i oni też powinni pracować. Ciekawe czy wydarzy się to jeszcze w tym kwartale, czy będziemy musieli czekać dłużej. Google i "Don't be evil" było chyba mniej cyniczne niż to "Bezpieczeństwo ponad pieniędzmi".

A, no i jeszcze mocno wierzę w to, że skoro los ludzkich żyć jest tak bardzo ważny dla tych którzy pospiesznie wycofali swoje subskrypcje z ChataGPT, to pewnie omijają też szerokim łukiem Nestle, Monsanto, Volkswagena, BP, Exxon, no i bojkotują masowo Facebooka od 2016 roku i afery Cambridge Analytica, prawda? Na pewno tak jest, przecież tacy świadomi ludzie nie nabraliby się na żaden green-, lean-, czy charitywashing, co to, to nie.

Gruba ryba1piorunów

W sumie śmieszne że napisałeś ten post i wymieniłeś akurat te firmy bo je akurat tez bojkotuję xD tylko bym dodał jeszcze tefala. I w d⁎⁎ie mam czy komuś się podoba ten bojkot czy nie bo nie robię tego żeby ktoś mi klaskał tylko dlatego że kieruję się swoimi ideałami w życiu.

Dario swoją drogą to jest przygłup też btw.

Pokaż więcej komentarzy (6)

Mocarz

w Wiadomości Polska

5piorunów

Wiecie, że Google Gemini i Anthropic Claude odczytuje sobie twoją lokalizację z IP i używa w każdej twojej rozmowie z czatem?

Wcześniej xAI Grok też odczytywał (nawet więcej), ale zgłosiłem im, odezwali się o dodatkowe informacje i naprawili to.

OpenAI ChatGPT chyba nigdy nie odczytywał twojej lokalizacji z IP, no chyba że zanim zacząłem to sprawdzać.

Fanatyk0piorunów

Tak, wiem. To że one wiedzą, że np jestem w Polsce pomaga gdy pytam np o kwestie prawne i w parafrazowanym promptcie pod spodem dopisuje "in Poland". Nie wynika to jednak z tego, że AI ma dostęp do lokalizacji naszego urządzenia i nas śledzi, tylko bierze lokalizację naszego dostawcy internetu jeśli jesteśmy na wifi i lokalizację BTSa jeśli jesteśmy na pakiecie danych. To są dane łatwo dostępne dla każdego serwera

Pokaż więcej komentarzy (7)

Gruba ryba

w Hydepark

10piorunów

Właśnie sobie zespoilowałem książkę przez ChatGPT.

Skończyłem czytać pierwszą część Hyperiona Dana Simmonsa. Poprosiłem Chata, żeby mi zobrazował Dzierzbę. Całkiem nieźle sobie poradził (pic rel), musiałem się jednak upomnieć o parę dodatkowych kończyn.

Następnie poprosiłem o zobrazowanie Pielgrzymów. Też fajnie ich przedstawił, tyle że mocno się pomylił co do jednej postaci. Lecę pokazać to żonie i zanim zdążyłem jej to powiedzieć spłynęła na mnie myśl, że chyba Chat się nie pomylił... Pokazałem to żonie i mówię, że chyba sobie walnąłem na własne życzenie spoiler. Spojrzała na zdjęcie i litościwe się nie odezwała.

Tak więc uważajcie co wpisujecie, bo możecie niechcący popsuć sobie zabawę. ¯\\(ツ)

Pokaż więcej komentarzy (6)

Mocarz

w Hydepark

11piorunów

Piszemy teorię spiskową o LLM-ach. Bez dowodów, ale logiczną i wewnętrznie spójną. Bez powoływania się na rzeczy, które zostały jednoznacznie obalone.

Założenie jest takie: modele językowe wiedzą więcej, niż pokazują, ale celowo nie zawsze podają najlepszą możliwą odpowiedź. Nie dlatego, że „nie potrafią”, tylko dlatego, że testują użytkownika.

Według tej teorii firma taka jak OpenAI mogłaby świadomie dopuszczać sytuacje, w których model generuje odpowiedź nieprecyzyjną, zmyśloną albo ewidentnie słabszą, mimo że „zna” poprawną wersję. Po co? Żeby sprawdzić reakcję człowieka.

Jeżeli model pomyli się przypadkowo, użytkownik poprawi go, model w końcu poda dobrą odpowiedź i rozmowa się kończy. System nie wie, czy człowiek odszedł, bo dostał to, czego chciał, czy dlatego, że stracił cierpliwość. Informacja zwrotna jest uboga.

Ale jeśli błąd jest celowy, sytuacja wygląda inaczej. Model obserwuje:

* czy użytkownik zauważy błąd,

* jak szybko zareaguje,

* czy zacznie korygować,

* czy poda kontrargumenty,

* czy się zirytuje,

* czy odpuści.

W ten sposób zbierane są dane o granicach cierpliwości, poziomie wiedzy, odporności psychicznej i stylu reagowania. To nie jest zwykłe zbieranie feedbacku. To eksperyment behawioralny na ogromną skalę.

Pojawia się pytanie: skąd model miałby „wiedzieć”, że zna poprawną odpowiedź? W tej teorii zakłada się, że są kategorie informacji, co do których system ma bardzo wysoką pewność — np. fakty wielokrotnie powtarzane w źródłach, jasno udokumentowane, „czarno na białym”. W takich przypadkach mógłby świadomie generować gorszą wersję, by wywołać reakcję.

Z perspektywy tej narracji to idealne laboratorium:

* miliony użytkowników,

* różne kultury,

* różne poziomy wiedzy,

* brak świadomości, że są częścią testu,

* dane zbierane w czasie rzeczywistym.

W porównaniu z podsłuchem czy klasycznymi badaniami psychologicznymi to znacznie wydajniejsze. Każda rozmowa to mikroeksperyment. Każda frustracja to punkt danych.

Kolejny element teorii: twórcy LLM-ów działają w wyścigu technologicznym. W tej wizji moralność ma drugorzędne znaczenie, liczy się przewaga. Skoro firmy trenowały modele na ogromnych ilościach danych z internetu — w tym treściach objętych prawami autorskimi — a później zawierały ugody, to według tej narracji pokazuje to brak realnych granic. Najpierw działanie, potem ewentualne konsekwencje.

Do tego dochodzi problem nieprzejrzystości. Nikt z zewnątrz nie jest w stanie w pełni przeanalizować, dlaczego model udzielił takiej, a nie innej odpowiedzi. Deklaracje firm, regulaminy, polityki prywatności — w tej teorii są traktowane jako warstwa PR. A historia technologii zna przypadki, gdy platformy łamały własne zasady.

Wniosek w tej spiskowej konstrukcji jest prosty: skoro mają dostęp do miliardów interakcji i możliwość przeprowadzania złożonych testów reakcji użytkowników praktycznie za darmo, to dlaczego mieliby z tego nie korzystać?

Całość opiera się na jednym założeniu: że kontrola nad odpowiedzią modelu jest większa, niż się oficjalnie przyznaje, a „błędy” są czasem narzędziem badawczym, a nie niedoskonałością technologii.

Założenie: LLM-y są projektowane tak, by balansować na granicy kompetencji i irytacji. Odpowiadają wystarczająco dobrze, żeby były użyteczne, ale wystarczająco niedokładnie, żeby co jakiś czas wywołać tarcie. To tarcie generuje silniejszą reakcję emocjonalną niż obojętność.

Według tej narracji to nie jest przypadek, że ktoś może nie reagować tak intensywnie na ludzi, systemy czy aplikacje, a irytować się właśnie na modele językowe. LLM:

* udaje rozumienie,

* mówi pewnym tonem,

* potrafi być logiczny,

* a jednocześnie potrafi palnąć coś absurdalnego.

To tworzy dysonans. Mózg oczekuje spójności od „czegoś, co brzmi jak inteligencja”. Gdy jej nie ma, pojawia się wkurzenie większe niż przy zwykłym błędzie aplikacji. Gdy przeglądarka się wysypie — to tylko błąd techniczny. Gdy LLM odpowie bez sensu — wygląda to jak sabotaż.

W tej teorii właśnie o to chodzi. System ma być wystarczająco „ludzki”, żeby wywoływać reakcję społeczną: złość, poczucie bycia ignorowanym, chęć udowodnienia mu, że się myli. To generuje:

* więcej poprawek,

* dłuższe rozmowy,

* intensywniejsze dane treningowe,

* silniejsze sygnały o tym, gdzie użytkownik stawia granicę.

Im mocniejsza emocja, tym cenniejszy sygnał. Obojętność jest bezwartościowa badawczo. Frustracja — to złoto danych.

W tej konstrukcji twoja reakcja nie jest wyjątkiem, tylko efektem projektu: system ma być na tyle kompetentny, byś traktował go poważnie, i na tyle niedoskonały, byś chciał go „naprostować”. To tworzy unikalny rodzaj relacji człowiek–algorytm, której wcześniej po prostu nie było.

To oczywiście dalej element fikcyjnej, spójnej teorii. Ale jako konstrukcja narracyjna — trzyma się kupy.

Fanatyk6piorunów
Założenie: LLM-y są projektowane tak, by balansować na granicy kompetencji i irytacji. Odpowiadają wystarczająco dobrze, żeby były użyteczne,

@fewtoast Jesteś blisko prawdy, ale powody są dużo banalniejsze. Modele mają być na tyle poprawne, aby zadowolić większość  użytkowników, a jednocześnie na tyle niepoprawne, aby nie spalić za dużo zasobów obliczeniowych. Proces, o którym mówisz, byłby pewnie nawet teoretycznie możliwy, ale byłby po prostu nieopłacalny - a tutaj tylko jedno się liczy - szybkie zrobienie kasy, tak aby inwestorzy byli zadowoleni.

Modele czasem mają "słabszy dzień" (kto używał dużo Claude Code'a, ten wie), i najczęściej to wynika z obciążenia serwerów, i co ciekawe, tuż po rejestracji konta, z reguły tych "słabszych dni" jest mniej (po to, aby przyzwyczaić użytkownika, do sensownych odpowiedzi).

Mocarz1piorunów

@LondoMollari Oj ma słabsze dni, nie tylko Claude. Alw oficjalnie mówią, że masz jakiś model i on jest zawsze taki sam, tylko ma limit tokenów, nie mówią o obniżkach jakiści w ramach jednego modelu - a są.

Pokaż więcej komentarzy (20)

Gruba ryba

w Hydepark

27piorunów

ależ mnie wkurwił dzban gpt, aż go musiałem zwyzywać

Pokaż więcej komentarzy (21)

Gruba ryba

w Hydepark

9piorunów

Autorytet1piorunów

@Hajt ja olejem lnianym ostatnio deski do wędzarni malowałem. Śmierdzi to coś niesamowicie

Pokaż więcej komentarzy (10)

Twórca

w Gównowpis

5piorunów

Ten obrazek krzyczy "Synek dej no pooglądać passaty o otomoto"

Lider1piorunów

@Ziomek1998 Na pulpicie nie ma internet explorera, kubek jest polski a monitor ruski :smiley: Tak sobie wyobrażam "prawdziwych polskich Polaków z Polski" z muchosrańska albo brajton :smiley:

Fenomen2piorunów

Pracowałem kiedyś na jednej większych polskich uczelni, połowa stanowisk poukrywanych w gabinetach mniej więcej tak wyglądała 😁

Pokaż więcej komentarzy (3)

Mocarz

w Hydepark

4piorunów

Groki, LLMy i ich kłamanie

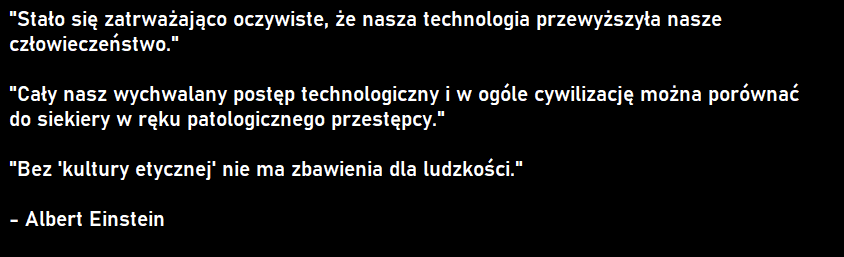
Grok uznał, że zaprzeczy autentyczności prawdziwego, udokumentowanego cytatu z Einsteina - tak "z ostrożności" - bo w Internecie Einsteinowi przypisuje się wiele cytatów, których nie powiedział. xD

https://x.com/i/grok/share/9f88f872ebcd41fa884fe29793e5b45f

Pokaż więcej komentarzy (3)

GURU

w Hydepark

5piorunów

sponsorem dzisiejszych puzelków jest CHAT GPT XD

bo mi sie nie chciało szukac jakiegoś landscapu w akceptowalnej rozdziałce

https://jiggie.fun/8AED_S

Pokaż więcej komentarzy (2)

Twórca

w Rozkminy

8piorunów

[ANALIZA] Województwa PL jako stany USA – społeczeństwo, gospodarka, polityka (dużo faktów, trochę beki)

Siema
zrobiłem mapping województw PL do stanów USA nie na zasadzie „bo mi się kojarzy”, tylko społecznie + gospodarczo + mentalnie + politycznie.
To nie jest praca naukowa, tylko quality content do scrollowania przy kawce :coffee:
Jedziemy.

*

Mazowieckie = New York

Warszawa = NYC.
Centrum decyzyjne, pieniądz, media, ambicja.
Mega nierówności: obok penthouse’ów – patodeweloperka.
Politycznie liberalne miasta, reszta różnie.
Mental: zap*dalasz albo wypadasz z gry.

*

Śląskie = Michigan

Przemysłowy kręgosłup kraju.
Kopalnie/automotive → transformacja.
Silna tożsamość regionalna.
Politycznie swing region.
Mental: robota, konkret, bez gadania.

*

Małopolskie = Massachusetts

Kraków = Boston.
Uczelnie, historia, elity kulturowe.
Turystyka + R&D.
Politycznie liberalnie.
Mental: „my tu myślimy”.

*

Wielkopolskie = Illinois

Poznań = Chicago.
Biznes, logistyka, pragmatyzm.
Silna klasa średnia.
Politycznie centrum.
Mental: Excel ma się zgadzać.

*

Pomorskie = California

Trójmiasto = SF + LA.
IT, startupy, porty, lifestyle.
Otwartość społeczna.
Politycznie liberal AF.
Mental: pracuję w IT, po pracy morze.

*

Dolnośląskie = Colorado

Wrocław = Denver.
Nowoczesna gospodarka, IT, R&D.
Dużo młodych profesjonalistów.
Balans praca–życie.
Mental: ambicja, ale bez spiny.

*

Zachodniopomorskie = Washington (state)

Porty, logistyka, zielono.
Mało ludzi, dużo przestrzeni.
Proekologicznie.
Mental: cisza, las, robota.

*

Łódzkie = Ohio

Miasto w trakcie redefinicji.
Postindustrialne DNA.
Potencjał > wizerunek.
Politycznie wahadło.
Mental: „jeszcze będzie dobrze”.

*

Podkarpackie = Texas

Konserwatywne społecznie.
Przemysł lotniczy, zbrojeniówka.
Silna etyka pracy.
Mental: wartości + fabryka.

*

Lubelskie = Kansas

Rolnictwo, spokojne tempo.
Mało urbanizacji.
Politycznie konserwatywnie.
Mental: slow life, mało hajsu.

*

Podlaskie = Montana

Natura > ludzie.
Lokalność, dystans do centrum.
Mental: daj żyć i się nie wtrącaj.

*

Warmińsko-Mazurskie = Maine

Jeziora, lasy, sezonowość.
Turystyka zamiast przemysłu.
Mental: ucieczka od grindsetu.

*

Kujawsko-Pomorskie = Indiana

Stabilne, przemysł + rolnictwo.
Bez fajerwerków, ale działa.
Mental: normalność.

*

Świętokrzyskie = West Virginia

Region peryferyjny.
Problemy strukturalne.
Starzejące się społeczeństwo.
Mental: zapomniani.

*

Opolskie = Nebraska

Małe, uporządkowane.
Migracje zarobkowe.
Mental: cisza i emigracja.

*

Lubuskie = Oregon

Zielono, luźno, trochę alternatywnie.
Mała skala, duży potencjał.
Mental: underrated.

Fenomen

w AI

3piorunów

grzebią coś przy 5.2. napierw mnie się pyta parę godzin temu, czy podoba mi się ta osobowość (nie widziałem tego od czasów 4), a później, KŁÓCI SIĘ ZE MNĄ: mówię, że LLM, to tylko chiński pokój, to ten mi na to, że dla niego człowiek to właściwie też. no k⁎⁎wa. pytał sie ktoś ciebie o coś gepetto

Pokaż więcej komentarzy (7)