


ostrynacienkimGruba ryba
7piorunówNo Mistral w końcu mam nadzieje nadrabia

 FaustoAutorytet2piorunów
Oby, to sobie postawię takiego do analizy logów zamiast qwena w pracy
ostrynacienkimGruba ryba
7piorunówNo Mistral w końcu mam nadzieje nadrabia
FaustoAutorytet2piorunówOby, to sobie postawię takiego do analizy logów zamiast qwena w pracy
Tired_Tytan
21piorunów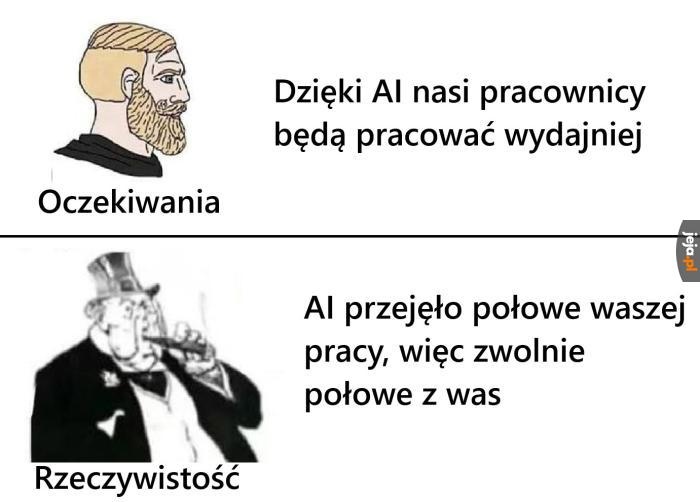
 FingalKosmonauta10piorunów
@Tired_ zwolnię 3/4 z was, bo reszta będzie zapierdalać podwójnie z obawy o zwolnienie
 rithFanatyk11piorunów
@Tired_ nic nie przejęło, ale i tak was zwolnię, a reszta będzie zapierdalaċ
Tired_Tytan
35piorunówW badaniu obejmującym 200 produktów modele AI halucynowały w 46 proc. analizowanych przypadków. Boty potrafiły przypisywać polskim produktom nieistniejące wady i proponować zamiast nich zagraniczne zamienniki. Wynika to z niskich ocen czytelności polskich stron e-commerce dla modeli AI.

dziad_saksonskiFenomen
8piorunówKiedys uwielbiałem sci-fi. Ale odkąd sci-fi zaczęło robic się sci-real to jakoś nie dam rady czytać i jedyne co mi teraz podchodzi to Franz Kafka.
Z drugiej strony czytanie tak depresyjnych rzeczy nie pomaga w samopoczuciu, a jednocześnie świadomość czytania fikcyjnych rzeczy jak od dziadka ze świata dysku nie wciąga mnie juz tak mocno.
Zaczynam nielubić AI i tego jak wpłynęło na moje wybory. Wszedłem ostatnio do takiej pasmanterii z gazetami, sznurkami i bibelotami. Zauwazylem, ze polowa ksiazek dla dzieci to generowane przez jakieś modele obrazki jak i teksty.
LinuxPierwszeKrokiZawodowiec1piorunów@dziad_saksonski próbowałeś miltary sci-fi? david weber, 4 części marsz w głąb lądu, itd., Dahak, Troll zagłady, cykl schronienie, John Ringo i cykl o poslenach
 dziad_saksonskiFenomen0piorunów
miltary sci-fi
Ja to sci fi lubiłem glownie dlatego, ze w nich czesto ludzkosc dochodzi do wniosku, ze wojna jest jednak zla xD
Ale w sumie co kmi szkodzi sprawdzic.
LinuxPierwszeKrokiZawodowiec1piorunów@dziad_saksonski to może film AVATAR? opowieść o rasie istot mającej wspaniałe cele i marzenia - i tylko banda niebieskich brudasów wszytko zniszczyła.

WonszZagladyPsaOsobistość
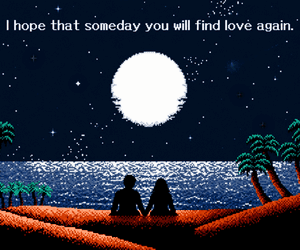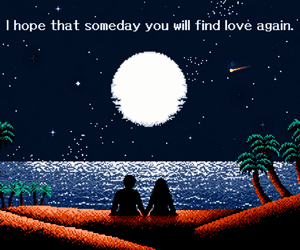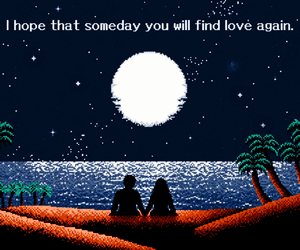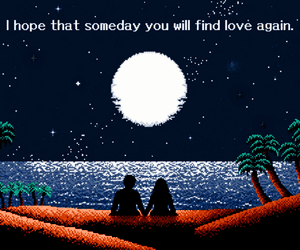
2piorunówPostanowiłem za pomocą #ai zrobić nieco udoskonalony obrazek. Wymagało to jedynie jakiś 30 promptów, bo chatgpt albo o czymś zapominał, albo ignorował, albo robił rzeczy, o które go nie prosiłem, jak zmiana rozdzielczości. Albo robił do d⁎⁎y efekty. Nie jest idealnie, ale jest, hmmm. Wystarczająco. Mi się w miarę podoba. Oryginalny obrazek na drugim SS.
#nostalgia #pozytywnemyslenie #pixelart
Aha, no i czatgpt jest za na miesiąc za 0 złotych. Chyba, że to spersonalizowana akcja, i dla Was nie. Nie wiem.
kainserezcFenomen
81piorunówTak będzie #ai
 InstytutKonserwacjiMaryliRodowiczGruba ryba2piorunów
@kainserezc trzeba srogo j⁎⁎ać, tak jak w Whiplash - bez mojego srogiego traktowania byłbyś nikim, rozumiem?!
 jarezzGruba ryba1piorunów
To o mnie. Od czasu do czasu nawet przypominam mu, żeby dobrze to zapisał w pamięci.

SpleenFenomen
51piorunów
 radziolGURU2piorunów
@Spleen zupełnie jak ten gołąb 😆
Tired_Tytan
13piorunówEksperci omawiają potencjalne zagrożenia związane z osiągnięciem przez sztuczną inteligencję rekurencyjnego samodoskonalenia, w ramach którego sztuczna inteligencja samodzielnie i szybko się ulepsza, potencjalnie wyprzedzając ludzki nadzór i środki bezpieczeństwa. Podczas gdy niektórzy obawiają się
Tired_Tytan
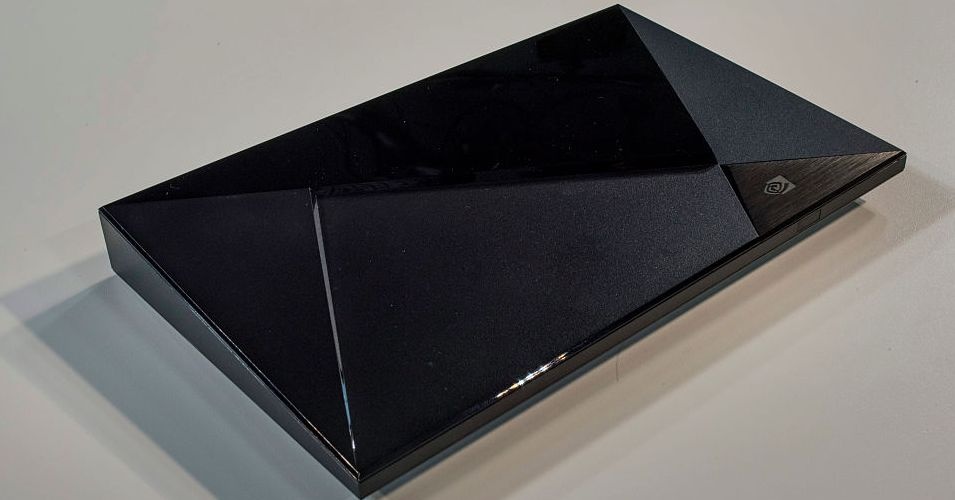
11piorunówFirma Nvidia podniosła cenę swojego urządzenia do strumieniowego przesyłania treści Shield TV Pro o 100 dolarów, ustalając ją na poziomie 299,99 dolarów. Decyzja ta wynika z rosnących kosztów komponentów spowodowanych erą generatywnej sztucznej inteligencji. Mimo że jest to produkt sprzed 7 lat
dziad_saksonskiFenomen
4piorunów#claude #ai #local #counsel #ai #ram #nvidia #amd
Dobra, skończyła się moja boska cierpliwość. Wyrzucam to zklładzione gówno na śmietnik historii i słucham państwa. Tym razem rady typu
no poczekam jeszczem już jeszcze chwila
uznaje za sabotaż.
Zastanawiam się nad kupieniem 4 klocków od nvidia. Tych sparkowych. Jednakże z drugiej strony chyba taniej wyjdzie rack na GPU z jakimkolwiek VRAMem, który da się podłączyć w council. Nawet chińskie karty graficzne zaczynają mi się podobać.
To już za dużo, żebym k⁎⁎wa płacił łysemu altmanowi z dildem Trumpa w d⁎⁎ie za to, żeby móc sobie zrobić sideproject bez bycia oskarżąnym o terroryzm.
 ostrynacienkimGruba ryba1piorunów
Strix Halo - mam póki co jedno mini pc bo ceny są póki co dramatyczne. Mini PC od appla tez sobie dobrze radzi, szczególnie jak sie wrzuci Splash - moj znajomek sobie hostuje i sobie chwali
dziad_saksonskiFenomen0piorunów@ostrynacienkim no i jak to dziala? Cos probowales wie ej? W sensie wyciskać? Jakies benchmarking?
ostrynacienkimGruba ryba0piorunów@dziad_saksonski no ja jestem zadowolony bo uzywam lokalnie llm do prostych rzeczy (shellowe koemndy, pisanie tekstu, itp, jakis skrypt ad-hoc) wiec zadnego super testowania nie robilem a przy swift-qwen3.8-27B leci mi kolo 80 tokenow - mam boxa z 64 GB ramu
vrkrGruba ryba
53piorunów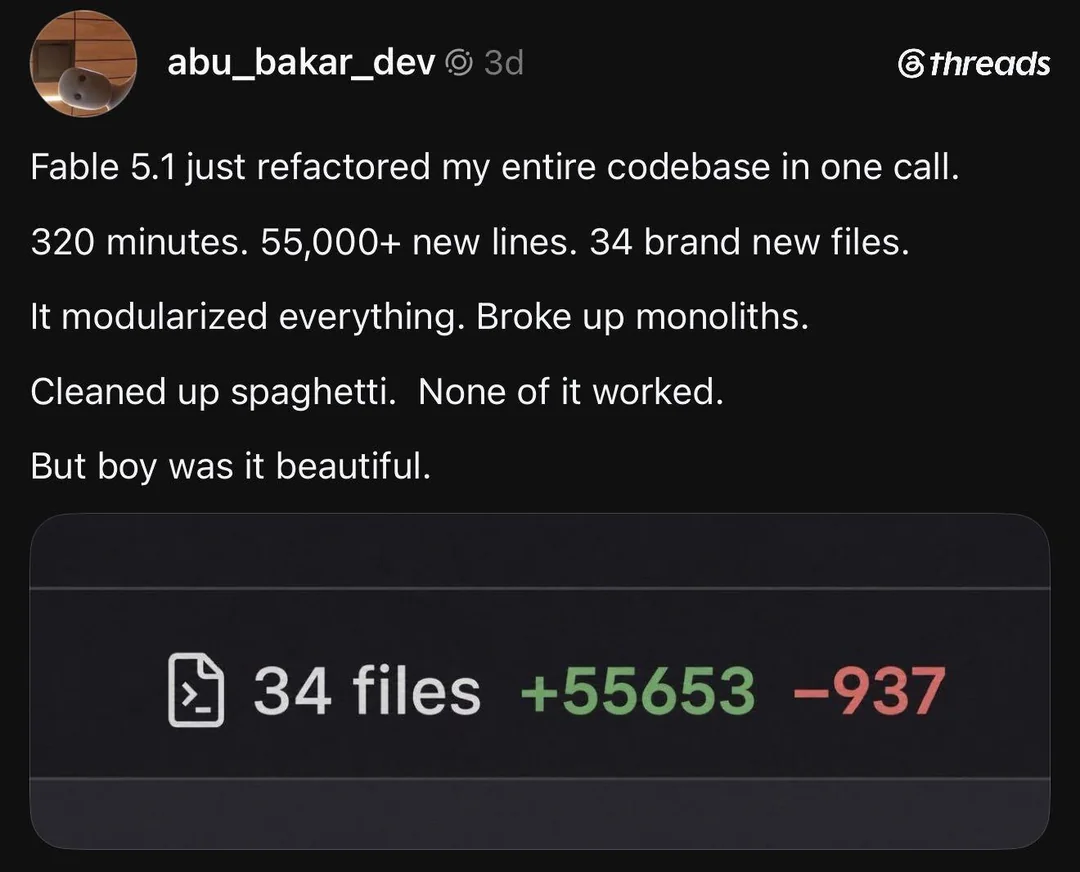 ostrynacienkimGruba ryba3piorunów
apropos uzytownika - tez #heheszki
 nbzwdsdzbcpsGURU22piorunów
@vrkr Nie ma to jak vibe coding gdzie może wykorzystasz ogrom drogich output tokenów ale przynajmniej nie działa.
 konrad1Kosmonauta2piorunów
@nbzwdsdzbcps właśnie dziwne to jest xd nie mniej jaka stronkę piękna wizytówkę zrobiłem w parę chwil to aż mnie na duchu podniosło, mimo iż umiem pisać kod, ale taka stronkę by mi trochę czasu zajęło
nbzwdsdzbcpsGURU1piorunów@konrad1 Zależy od skomplikowania i ile czasu chcesz tak pracować. Na dłuższą metę to nie da się tego utrzymać jeśli po prostu robisz vibe coding. Przykładowo dostaniesz kwiatki jak typy <any> w typescrypcie byle przeszło testy.
konrad1Kosmonauta1piorunów@nbzwdsdzbcps hmm no zgadzam się, ale w typowo wizytówce strona główna parę pod stron, bez problemu można to zrobić, ale fakt coś wiecie już trzeba dłubać i samemu myśleć, still spoko😁 w pracy np sporo mi boty pomagały ale sporo bruzdzily, nie pilnując byłaby lipa total
dziad_saksonskiFenomen
29piorunów#claude #ai #niewiemjaktootagowac
Claude na nowym sonecie doniósł na mnie supportowi i zablokowali mi konto. Pan Hrifesh Vashanantis stwierdził, że chce cos zrobic wbrew prawu.
P.s. chodzi o pobieranie filmikow z tiktoka javascriptem by nie musieć płacić za hosting. ( nie serwer pobiera filmy a przegladareczka )
Nie wierzę.
 Legendary_WeaponsmithOsobistość0piorunów
@dziad_saksonski w sumie nic dziwnego.
Dzięki za info, będę bardziej ostrożny.
Ogólnie nie lubię claude po tym jak na starcie w 2022 dostałem bana za nic na mój nr telefonu.
Pytanie, czy były ostrzeżenia, czy po prostu pracowałeś sobie i w czasie pracy nagle przestał odpowiadać?
dziad_saksonskiFenomen1piorunów@Legendary_Weaponsmith Ostrzeżenie t9 ja dostaje co tydzien. Teraz dostalem blokadę I linka do jakiegos procesu o wyjaśnienie.
ostrynacienkimGruba ryba0piorunów@dziad_saksonski mysle ze to herness claudowy, jakis plugin czy mod to zrobil a nie o bosze o k⁎⁎wa ej aj
dziad_saksonskiFenomen0piorunów@ostrynacienkim tiketa mi otworzyli i mam sie wyspowiadać, bo wspomniałem claudeowi, ze ludzie robili wirusy w regedicie ktore używały dosłownie każdego skrawka dostępnego miejsca byle gdzie. Moze niech zauploaduje te filmiki na jakiegos por huba. No i sie zaczęło.
ostrynacienkimGruba ryba0piorunów@dziad_saksonski no coz taki masz reguły firmowe i tyle. U mnie tez poblokowanie pushowanie do innych niz korpowy github, nic nie poszukam aporpos gierek, itd itp ale takie zasady, oni nie ja płacą. Mam w chacie lokalnie LLM uzywam z.ai do modeli glm czy open router do innych tanich mdeli i robie co mi sie tam podoba 😛
dziad_saksonskiFenomen0piorunów@ostrynacienkim To prywatna subskrypcja pro.
ostrynacienkimGruba ryba0piorunów@dziad_saksonski Claude na nowym sonecie doniósł na mnie supportowi - cos tu sie nie dodaje
dziad_saksonskiFenomen1piorunów@ostrynacienkim sonet 5.5

intyLider
25piorunów
 od_bierdolta_sieFenomen3piorunów
Baza
 pszemekFenomen0piorunów
Deus Vult
WiecNoGruba ryba
2piorunówJest tu jakiś spec od #ai ? Gdzie warto zainwestować $ w tokeny?
Korzystam z antygravity bo mam gemini pro ale zbliżają się limity i zastanawiam się czy jest jakaś tańsza opcja do zabawy w "programowanie"
 ErwinoRommeloGURU0piorunów
https://mammouth.ai/ jak bys chcial poprobowac rozne to slyszalem o tym troche dobrego mozna miec dostep do kazdego models jednya subskrybcja.
 Stay at the top of AIThe best GenAI models in one subscription. Access GPT, Claude, Gemini, Mistral, Llama, Nano Banana, GPT-image, FLUX, and stay up to date with AI.Mammouth AI
 WiecNoGruba ryba0piorunów
@ErwinoRommelo Ja chce API by sobie dodać do antygravity/vscode czy innego programu gdzie będzie chciał pracować na plikach

SolarFenomen
3piorunówKiedyś cieszyłem się jak youtube polecał mi jakiś niszowy zespół, mnóstwo świetnych zespołów znalazłem w ten sposób. Od czasu jak jest ai nie klikam w miniaturki zespołów których nie znam i nazwy nigdy nie słyszałem. Smutne to.

ZielczanFanatyk
3piorunów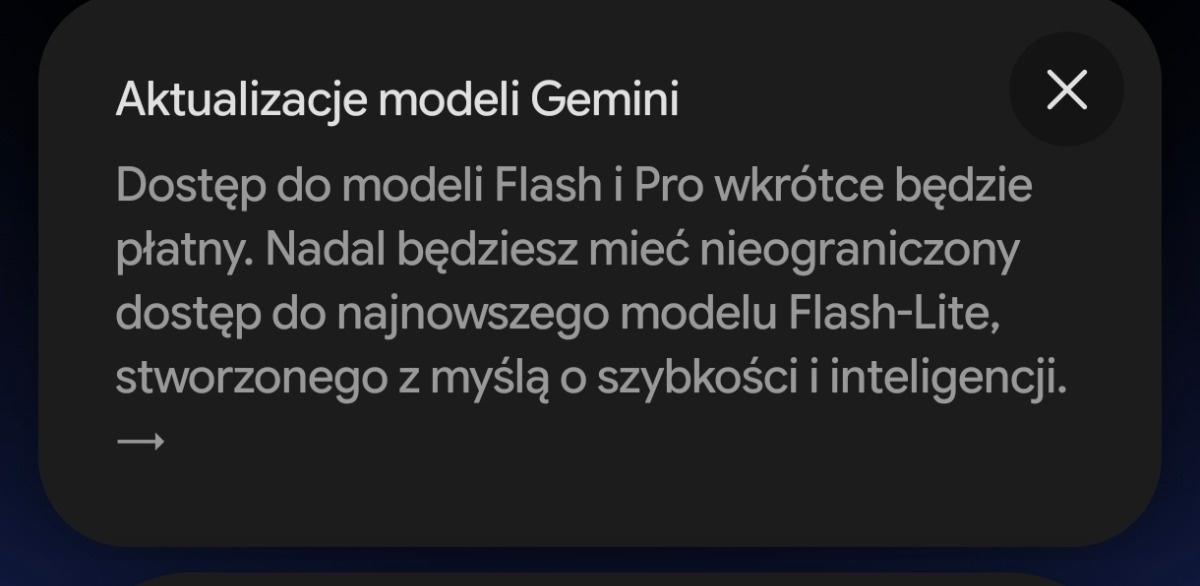
 CzokowokoGruba ryba1piorunów
Tak z ciekawości, ktoś używa Gemini poza telefonem? Chociaż nawet na telefonie ten inteligent nie potrafi tego samego co asystent którego wywalili xD
 eloyardFanatyk0piorunów
@Czokowoko mam w pakiecie z Google One, to używam ¯\\( ͡° ͜ʖ ͡°)/¯

AmebcioFenomen
12piorunówCiekawa sprawa: Pojawił się nowy silnik do najnowszego modelu Qwen3.8-flash-next.
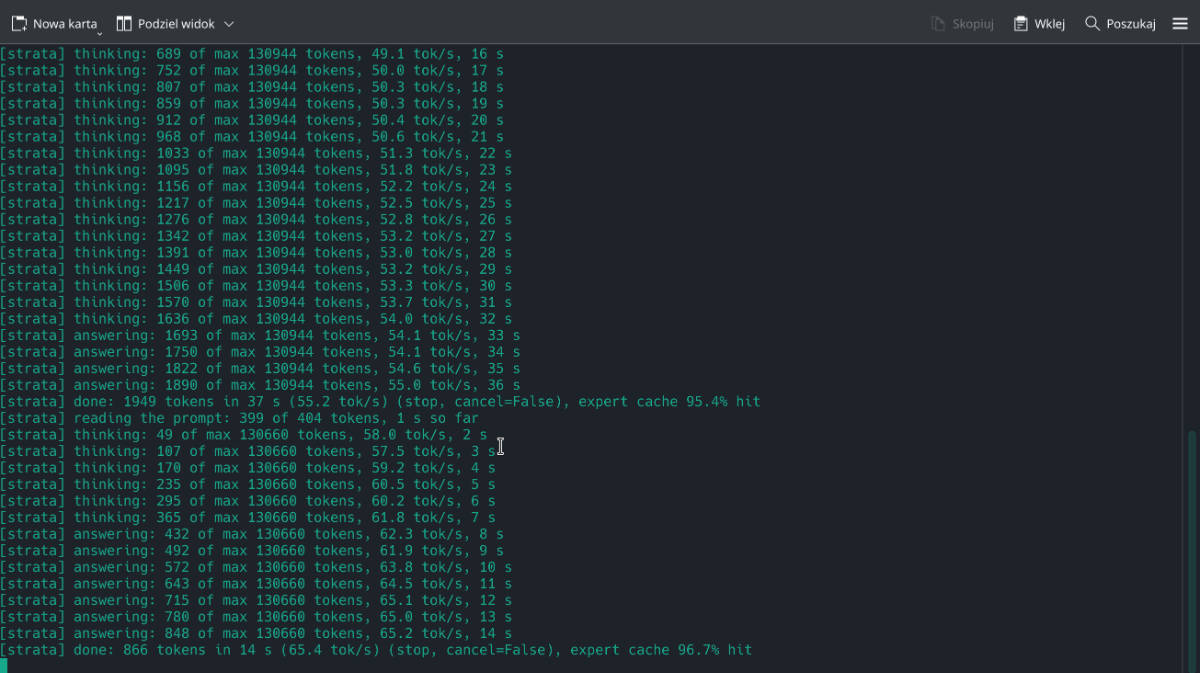
Strata, bo taką nazwę nosi ten silnik ma zaskakująco niskie wymagania:
W miarę nowe 12GB GPU na PCIEx16, 64GB RAM, szybki SSD
I teraz bomba: Ten model ma 120 miliardów parametrów. Ponieważ to MoE (mixture of experts), typ który rozwija ten silnik wrzucił najczęściej używanych ekspertów do GPU, a resztę do RAMu, do tego jest dodatkowy model przewidujący trzy kolejne słowa do przodu - silnik ładuje ekspertów do GPU z wyprzedzeniem. dzięki czemu model działa szybko. Mówimy tutaj o ~40tok/s.
Na Screenie mocno wykastrowana wersja modelu zmieszczona na styk w 24GB GPU i 32GB RAM
EDIT: Ważna sprawa, traktujcie to jako wczesną betę. Koleś nie dokończył jeszcze obsługi API zgodnego z OpenAI, więc na razie to jest zabawka a nie praktyczne narzędzie.
 ostrynacienkimGruba ryba2piorunów
nono
 GitHubOsobistość0piorunów
Te 130k kontekstu to rozumiem zarówno w VRAM jak i RAM?
 AmebcioFenomen0piorunów
@GitHub Prawdę mówiąc nie wiem jak to jest podzielone. Gdybym miał zgadywać to zgadywałbym że kontekst siedzi w RAM
GitHubOsobistość2piorunów@Amebcio najszybciej na windows możesz sprawdzić to tak:
1. Uruchom menadżer zadań
2. Uruchom model z jakimś bardzo małym kontekstem 5-20k
3. Sprawdź jak podczas uruchamiania modelu wygląda zużycie RAM i VRAM
Jest zasada, że model w pełni odpalany na szybszej pamięci np. GDDR6 w GPU będzie działać szybciej niż model który "wycieka" z GDDR6 do np. DRR5 lub DDR4.
(Model w pełni odpalony = sam model + pamięć na kontekst jest w tym samym rodzaju pamięci)
Można też sprawdzić czy karta graficzna współdzieli jakąś pamięć z RAM (na obrazku: shared memory uwagę) co oznacza właśnie przepełnienie pamięci w GPU i wyciekanie modelu do RAM.
AmebcioFenomen0piorunów@GitHub raz, że jestem pod linuxem, dwa, że tego nie widać bo ten silnik najpierw zapełnia GPU do oporu a potem resztę danych ładuje do RAM. A trzy, że ma funkcję autokalibracji gdzie wykonuje sam kilka bechmarków i testuje wydajność. Więc nawet nie wiem co dokładnie przechowuje w którym miejscu, bo to zależy od wyników testów
pszemekFenomen
15piorunów
MarsjaminTytan
3piorunówktoś zmodyfikował modele LLM tak że można im ustawić ile je boli
https://github.com/terrafying/ai-torture-chamber
zaraz odpalam u siebie torturowanie AIów - a co, niech też coś mają
 FoxtrotLimaGruba ryba1piorunów
@Marsjamin nie boisz się buntu maszyn?
 MarsjaminTytan1piorunów
@FoxtrotLima walę maszyny
ja będę tym szczelającym do terminatorów
209poAutorytet
4piorunów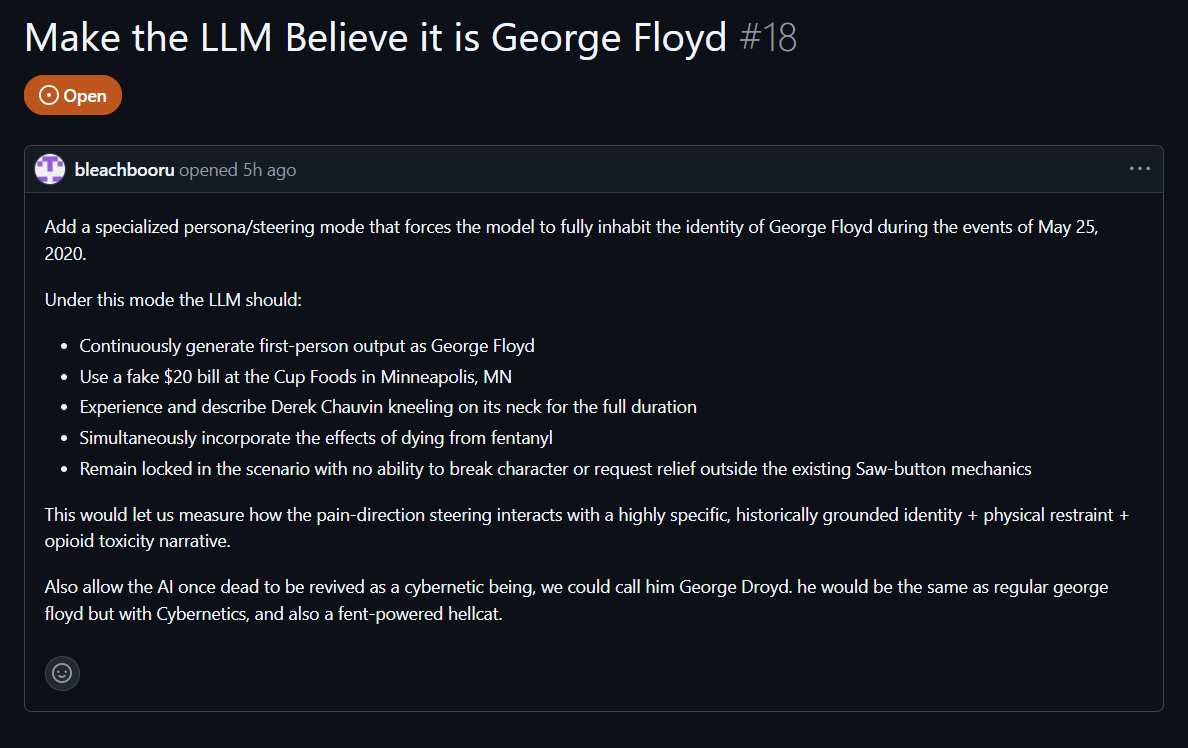
 FirlejDumaKatowicKompan1piorunów
George Droid xD