Hejto.pl
Dodaj post

Wpisz coś do wyszukania (minimum 2 znaki)

Programowanie

Kategoria: Technologia

  • 1506 członków
  • 1223 wpisy

Gruba ryba

w Programowanie

11piorunów

Trafiłem na artykuł ithardware w którym piszą oni o repo na githubie w którym facet wysexploitował jak odblokować wyższą moc GPU na kart NVIDIA 30XX https://ithardware.pl/aktualnosci/nvidia_rtx3090_gpu_unlock-55421.html

Jeśli ktoś jest zainteresowany wrzucam link do repo. https://github.com/Zagitta/gpu-unlock/blob/main/docs/How%20Ampere%20was%20unlocked.md

Z tego co widzę wszystko polega na modyfikacji bitów rejestru procka, poprzez exploit z secure bootem (bardzo secure xddd)
Czy gry będą chodzić lepiej? Nie.
Czy lokalne LLMy będą chodzić lepiej? Tak ale zależy od karty.

Gruba ryba2piorunów
Osobistość0piorunów

@Czokowoko

Czy gry będą chodzić lepiej? Nie.
Czy lokalne LLMy będą chodzić lepiej? Tak ale zależy od karty.

Czyli generalnie bezużyteczne

Pokaż więcej komentarzy (9)

Zawodowiec

w Programowanie

8piorunów

Outbox pattern - devszczepaniak.pl

W systemach asynchronicznych drobna awaria może doprowadzić do niespójności danych. Wystarczy, że zapis w bazie danych się powiedzie, ale powiązane z nim zdarzenie nigdy nie trafi do message brokera. W najnowszym artykule wyjaśniam, jak Outbox Pattern pomaga rozwiązać ten problem. Pokazuję też, na

Gruba ryba

w Programowanie

11piorunów

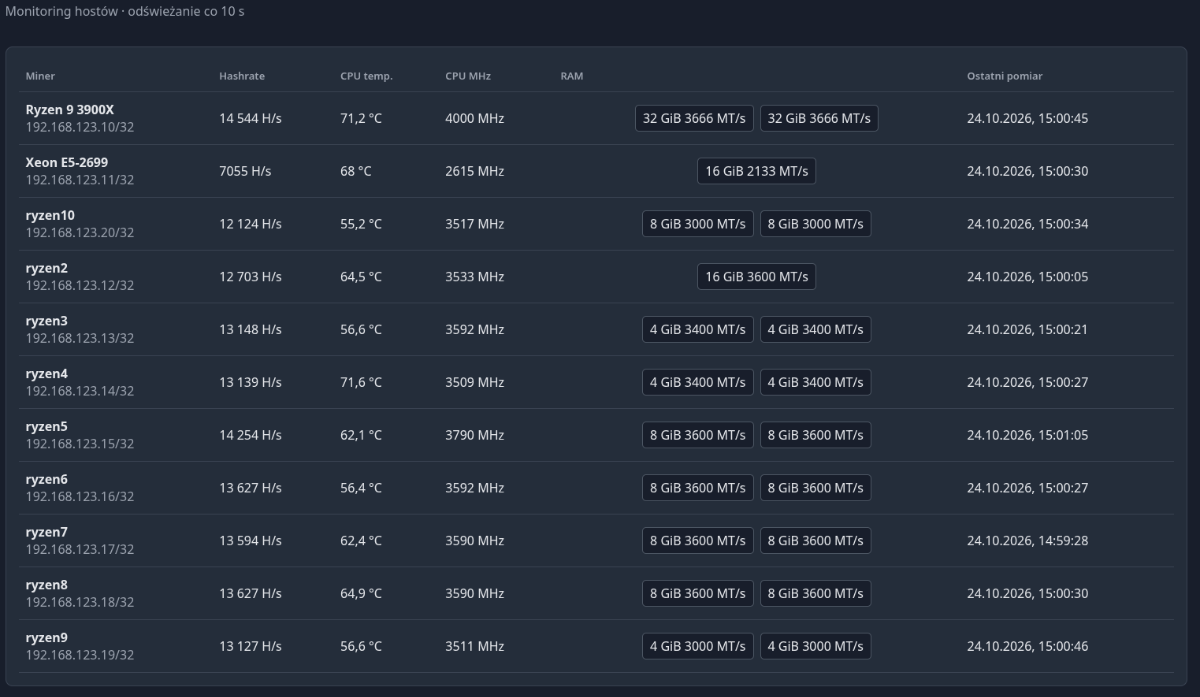
Przy pomocy darmowego ChatGTP napisałem sobie wczoraj system monitoringu koparek. To co widzicie to listing odświeżany co 10 sekund, dane pobierane są z bazy danych a do bazy wpisuje je skrypt który parsuje logi. Wymyśliłem sobie, że skoro na każdej koparce działa logger i te logi mogą być przesyłane na serwer to co za problem napisać skrypt, który będzie nasłuchiwał na logach programu kopiącego i gdy pojawi się tam nowa wartość na temat wydajności to zostanie przesłana do logów.
W skrócie zwykły skrypt w bash działa sobie w pętli która czyta logi. W momencie odpalenia zbiera też dane systemowe i je po prostu loguje. Logi są wysyłane na zdalny serwer przez program do logów (metalog). Na serwerze logi są odbierane przez program do obsługi logów (syslog-ng). Na serwerze działa kolejny skrypt który czyta logi syslog-ng i gdy pojawią się tam nowe wpisy to zapisuje je do bazy danych. Kolejny skrypt tym razem w pythonie odpowiada za pobieranie danych z bazy i generowanie strony WWW która jest hostowana przez nginx. Działą to znakomicie - teraz mam bezpośredni podgląd na parametry sprzętowe, wydajnościowe oraz monitoring zdrowia dla wszystkich koparek jednocześnie. Od razu widzę gdy gdzieś wydajność spada albo temperatura rośnie. Od razu wiem gdzie jest najsłabsze ogniwo. Rewelacja dlatego musiałem się pochwalić.

P.S. Oczywiście znajdą się puryści którzy będą twierdzić, że przecież skrypty na koparkach mogły by pisać bezpośrednio do bazy danych. Tylko, że wtedy trzeba by instalować kupę pakietów na każdej koparce do obsługi postgresql'a a później to aktualizować. Wolałem tego uniknąć bo na koparkach jako dyski mam pendrivy po 20 PLN sztuka z ograniczoną ilością miejsca i jeszcze bardziej ograniczoną prędkością zapisu więc staram się aby systemy operacyjne koparek były ograniczone do minimum.

Gruba ryba2piorunów

@StepujacyBudowlaniec

P.S. Oczywiście znajdą się puryści którzy będą twierdzić, że przecież skrypty na koparkach mogły by pisać bezpośrednio do bazy danych

Oczywiście. Ale to działa, łatwe do utrzymania i mała szansa że się spierdoli. Piorun

Tytan1piorunów

@StepujacyBudowlaniec Nice!

Skoro jednak już o tym wspomniałeś, to z tego co patrzę to można postawić RESTa do którego skrypty na koparkach pisałyby curlem, w ten sposób wcale nie musiał byś bawić się w instalację czegokolwiek.

Mam awersję do czytania logów w ten sposób, bo to ma krótkie nóżki: logi mają luźny format, więc rozszerzanie przesyłanych informacji może stać się karkołomne, baza danych jest już bardzo dobrym interfejsem sama w sobie, a postgresql obsługuje nawet natywnie JSONy, ma replikację, protokół itp. LLMy z kolei takie proste serwisy przekierowujące dane przez REST ogarniają od strzała.

Think about it!

Pokaż więcej komentarzy (8)

Fenomen

w Programowanie

4piorunów

Jak najlepiej sobie ustawić zarobki na Google Play pod aplikację?

Reklamy statyczne? Dynamiczne blokujące? Może jakiś freemium, a potem premium ( no ale to bez bazy usprawiedliwienie sie nie obędzie ).

Sa te poradniki za 50 zl z promptowaniu czytanki, ale samo to nawet nie pomaga. Myslalem nad freemium ilościowym. 10 razy mozna uzyc a potem trzeba kupić wersję pelnoprawną.

Pokaż więcej komentarzy (7)

Sum

w Programowanie

4piorunów

Witam Państwa, kto uważa ten feature za zjebany zapraszam do lajkowania:
https://github.com/microsoft/vscode-dotnettools/issues/3190

Fanatyk0piorunów

@potato_fairy Cieszę się, że przez całą karierę udało mi się ominąć używanie tego gówna. Ostatnio wróciłem do klasyki, i siedzę w pomodzonym Vimie a robotę robi Claude, wcześniej glównie Eclipse i Jetbrainsy.

Fanatyk0piorunów

@Catharsis Może przetestuję, ale problem jest taki, że kiedy masz dobrze obcykanego Vima, to i poruszasz się po nim intuicyjnie, to nie opłaca się inwestować czasu w nowe narzędzie, o ile nie wnosi bardzo, bardzo dużo.

No i strona, która totalnie zamuliła przeglądarkę kiedy ją otworzyłem trochę mnie zniechęciła. ( ͡° ͜ʖ ͡°)

Pokaż więcej komentarzy (7)

Zawodowiec

w Programowanie

6piorunów

Entity i Value Object w Domain-Driven Design - devszczepaniak.pl

Entity i Value Object to jedne z podstawowych building blocks taktycznego Domain-Driven Design. W artykule pokazuję, czym się różnią, jak wykorzystać je do pilnowania inwariantów oraz w jaki sposób można je wykorzystać, by ograniczyć problem Primitive Obsession. #programowanie #informatyka

Lider

w Programowanie

14piorunów

. źródło

Autorytet0piorunów

Generalnie te skracanie nazw to patologia. Ma to sens w przypadku komend do terminala, ale w kodzie to nie ma sensu w ogóle. Dużo więcej czasu spędza się na czytaniu kodu niż jego pisaniu. Dlatego powinno cisnąć się na czytelność i jasne nazwy.

Gruba ryba2piorunów

@malkontenthejterzyna

Zakładam, że niewiele pracowałeś z linuksem/uniksem, więc filozofia tamże stosowanego nazewnictwa jest Ci obca.

1. Krótkość nazw poleceń oszczędza Twoje dłonie i przyspiesza Twoje tempo. Jeśli tekst jest Twoim środowiskiem, to kazdy oszczędzony* znak robi Ci duża różnicę.

2. Skrócone nazwy mają sens. To po prostu zwykły obcy język. A w dodatku skrótowce są tak dobrane, że łatwo je zapamiętać.

3. Paradoksalnie, skrótowce motywują Cię do tego by się uczyć polecen. Ba, po to można robić aliasy, by skracać to jeszcze bardziej.

A dla ludzi, którzy blednie sądzą, że powershell jest lepszy:

grep -HR some_text *.log

Get-ChildItem -Recurse -Filter *.log | Select-String -Pattern "some_text" -CaseSensitive

* Jeśli znasz polecenia. Jeśli nie znasz, to używanie powershella też nie będzie frajda, bo konia z rzędem temu, kto bez czytania instrukcji się domyśli jak działa get-childitem

Osobistość1piorunów

@malkontenthejterzyna Nah, swego czasu śmiano się z Javy że jest bardzo ekspresyjna i kod jest długi przez długie nazwy. Skracanie (z umiarem) ma ogromny plus tworząc krótszy kod który mimo skróconych nazw będzie czytelniejszy niż funkcja na 3 słowa z dokładnym opisem co robi itp. Chociaż w wypadku creat -> create to nie robi większego znaczenia.

Pokaż więcej komentarzy (6)

Gruba ryba

w Programowanie

17piorunów

GURU4piorunów

Wez wczoraj spalilem 4 jointy i tokenow
Jak maly kraj a koncowa animacja dymu byla tak ch⁎⁎⁎wa ze ja wylaczylem kazalem mu zapisac w md files ze jest pedalem i poszedlem spac

GURU4piorunów

@Thereforee ja : You fuckn fag this shit is kurwa disgusting how many time do i have to repte not to mess up with particles velocity shits get broken when you touché those values you usless shitstained pussyfart : Claude : the user is highly disatisfied with the final result next time i will need to change my approach.

Pokaż więcej komentarzy (6)

Debiutant

w Programowanie

15piorunów

Hej! Przez ostatnie miesiące budowałem SIDapticusa - otwartoźródłowy player plików .sid, w którym ESP32-S3 emuluje procesor 6510 i potrzebne mu kawałki C64, uruchamia natywne playery SID, a dźwięk generuje prawdziwy SID.

Projekt rozrósł się trochę bardziej, niż pierwotnie planowałem. Być może znajdziecie w nim coś dla siebie:

1. Programiści retro/emulacji: cycle-accurate emulator 6510 i układów CIA w C++, wszystkie 256 opcode'ów, BCD, page crossing, dummy writes, przerwania i banking $01.

2. Embeddowcy: pełny determinizm na ESP32-S3, odłączenie rdzenia od FreeRTOS, arbitraż IRAM/SRAM1, Dedicated GPIO, linker script, ESP-IDF.

3. Elektronicy: crowbary, aktywne bleedery, sekwencjonowanie zasilania, op-ampy, analogowy tor audio i routing sterowany cyfrowo.

4. Szaleńcy: to wszystko na stykówce. 😁

Kod, dokumentacja i hardware są tutaj:

https://github.com/hankdraco/sidapticus

Jeżeli któryś z tych tematów Cię zainteresował - zajrzyj. A jeśli znajdziesz coś, co zrobiłem głupio, ciekawie albo po prostu inaczej niż Ty byś to zrobił, chętnie posłucham.

A jeśli po prostu chcesz posłuchać, jak brzmią prawdziwe SIDy, to zapraszam na demo tutaj:

https://hankdraco.github.io/sidapticus-demo

Pokaż więcej komentarzy (4)

Zawodowiec

w Programowanie

4piorunów

Język wszędobylski (Ubiquitous Language) - devszczepaniak.pl

AI jest wykorzystywana zarówno przez zespoły deweloperów i architektów jak również przez biznes i ekspertów domenowych. Sprawia to, że język wszędobylski (Ubiquitous Language) zyskuje jeszcze większe znaczenie i wartość w codziennej pracy. Ubiquitous Language to wspólny język domenowy, który pozwala

Kompan

w Programowanie

13piorunów

A wiec zacznijmy od tego, że zaczęło się od posta na Reddicie. Ktoś szukał sposobu na odzyskanie klasycznych poziomych rzędów zamiast obecnego masonry grid. Też za nimi tęskniłem, więc zamiast dalej szukać rozwiązania, zrobiłem własne.

Tak powstało Classic View for Google Images.

Rozszerzenie:

• przywraca poziome, wyrównane rzędy obrazów

• pokazuje większy podgląd po najechaniu

• dodaje przycisk View Image

• pozwala zmieniać wysokość rzędów i odstępy

• ukrywa powiązane wyszukiwania

• oznacza lub ukrywa prawdopodobnie wygenerowane obrazy AI

Wykrywanie AI działa lokalnie i bez żadnego zewnętrznego modelu. Sprawdza oznaczenia Google, tytuły wyników, nazwy generatorów, domeny źródłowe i dostępne metadane. Nie jest nieomylne, ale przy wyszukiwaniach typu "AI generated portrait" radzi sobie całkiem sensownie. 😉

Rozszerzenie jest darmowe, nie ma reklam, analityki ani zbierania historii wyszukiwania.

Chrome Web Store:

https://chromewebstore.google.com/detail/classic-view-for-google-i/ncljfdlnfncafnmcfbdkobjdpfiodfcg

Strona z filmem i opisem:

https://images.hsr.gg/

Osobistość3piorunów

Ja to tęsknie za starym wyszukiwaniem grafiki za pomocą google. W sensie ten nowy Obiektyw Google potrafi być użyteczny ale czasem wolałbym po prostu to stare szukanie podobnych grafik bez żadnych AI i innych bajerów.

Gruba ryba

w Programowanie

12piorunów

Kolega zoptymalizował użycie Postgresa, więc możemy wy⁎⁎⁎ać narzędzie do raportowania. Wymaga to przepisania zapytań z języka tamtego narzędzia na SQL.

Prosta zasada - jeden wykres, jedno zapytanie.

Kolega zajmuje się bazami danych, a ja zajmuje się wykonywaniem do nich zapytań. Byłem na urlopie, a terminu gonią. Poprosiłem go, żeby mi przygotował zapytania zastępujące te obecnie istniejące.

Starych wykresów było 18, nowych najwyraźniej będzie 35.

Kocham prace przy wsparciu sztucznej inteligencji 💪

Pokaż więcej komentarzy (5)

Zawodowiec

w Programowanie

6piorunów

Dlaczego NIE warto delegować kodowania agentom AI - devszczepaniak.pl

Delegowanie pisania kodu do AI ma ogrom zalet. W ciągu ostatnich dwóch lat, za sprawą narzędzi AI, wyprodukowałem wielokrotnie więcej kodu niż kiedykolwiek wcześniej. Przez ten czas zacząłem jednak dostrzegać sporo istotnych wad tego podejścia. O tym, jakie problemy dostrzegam w tym sposobie pracy

Zawodowiec

w Programowanie

5piorunów

EventCatalog - SKUTECZNA dokumentacja architektury Twojego systemu - devszczepaniak.pl

EventCatalog to narzędzie do dokumentowania architektury systemów w podejściu Documentation as Code. Pozwala opisywać zdarzenia, komendy, usługi, domeny i przepływy między nimi. Dzięki temu wiedza o architekturze trzymana jest blisko kodu i jest łatwiejsza w utrzymaniu. W najnowszym artykule

Gruba ryba

w Programowanie

37piorunów

4 godziny czytania i komentowania AI slopu czyli Grzechy główne tym razem;

1. robienie tego samego na piec różnych sposobów jednocześnie

2. testowanie i przepisywanie biblioteki standardowej na nowo

3. antywzorce pomieszane z poprawnymi wzorcami naprawiającymi antywzorce z tego samego PRa

4. komentarze funkcji albo tlumaczace oczywistości albo niezgodne z dokumentacja interfejsów których używają

5. testy sprawdzające nieistotne szczegóły implementacyjne, albo wprost sanity check kompilatora (np jak zachowa się wartość bez inicjalizacji)

Dla mnie to wygląda tak: dla biedoty AI slop, dla bogatego korpo ludzka uwaga dla ich produktu za wielki hajs (wielki bo łatwo udawać ze się uwagę poświęca, więc jeśli nie dajesz opcji/akcji -> lepiej przed tobą udawać a uwagę poświęcać tam gdzie się opłaca przez compound interest a nie liniowa wymianę czasu za kapitał)

Ciężko stwiedzic jak bardzo schizofrenicznie to brzmi, dajcie znać proszę :man-bowing:

Autorytet3piorunów

Rel.
Ostatnio chciałem, żeby mi AI prosty formularz napisał, to opakował w jakieś style, komentował banały i się nad tym zastanawial 2 minuty. A jak kazałem poprawić, to siedział kolejne 2 minuty usuwając zbędny kod XD
a pisanie testów Assert.IsTrue(true) to klasyka.
To się świetnie nadaje do automatyzacji albo jako żółta kaczuszka, ale strasznie durne narzędzie. Vibe coding to musi być tragedia projektowa.

Pokaż więcej komentarzy (34)

Lider

w Programowanie

16piorunów

Pierwsze README napisane przez w 2005. W następnym commicie który dotyka tego pliku obok zmienił .dircache/index -> .git/index.

https://github.com/git/git/commit/e83c5163316f89bfbde7d9ab23ca2e25604af290#diff-2b7814d3fca2e99e56c51b6ff2aa313ea6e9da6424804240aa8ad891fdfe0900

GIT - the stupid content tracker

"git" can mean anything, depending on your mood.

- random three-letter combination that is pronounceable, and not
actually used by any common UNIX command. **The fact that it is a
mispronounciation of "get" may or may not be relevant.**
- stupid. contemptible and despicable. simple. Take your pick from the
dictionary of slang.
- "global information tracker": you're in a good mood, and it actually
works for you. Angels sing, and a light suddenly fills the room.
- "goddamn idiotic truckload of sh*t": when it breaks

This is a stupid (but extremely fast) directory content manager. It
doesn't do a whole lot, but what it does do is track directory
contents efficiently.

There are two object abstractions: the "object database", and the
"current directory cache".

The Object Database (SHA1_FILE_DIRECTORY)

The object database is literally just a content-addressable collection
of objects. All objects are named by their content, which is
approximated by the SHA1 hash of the object itself. Objects may refer
to other objects (by referencing their SHA1 hash), and so you can build
up a hierarchy of objects.

There are several kinds of objects in the content-addressable collection
database. They are all in deflated with zlib, and start off with a tag
of their type, and size information about the data. The SHA1 hash is
always the hash of the compressed object, not the original one.

In particular, the consistency of an object can always be tested
independently of the contents or the type of the object: all objects can
be validated by verifying that (a) their hashes match the content of the
file and (b) the object successfully inflates to a stream of bytes that
forms a sequence of + + <ascii decimal
size> + <byte\\0> + .

BLOB: A "blob" object is nothing but a binary blob of data, and doesn't
refer to anything else. There is no signature or any other verification
of the data, so while the object is consistent (it is indexed by its
sha1 hash, so the data itself is certainly correct), it has absolutely
no other attributes. No name associations, no permissions. It is
purely a blob of data (ie normally "file contents").

TREE: The next hierarchical object type is the "tree" object. A tree
object is a list of permission/name/blob data, sorted by name. In other
words the tree object is uniquely determined by the set contents, and so
two separate but identical trees will always share the exact same
object.

Again, a "tree" object is just a pure data abstraction: it has no
history, no signatures, no verification of validity, except that the
contents are again protected by the hash itself. So you can trust the
contents of a tree, the same way you can trust the contents of a blob,
but you don't know where those contents came from.

Side note on trees: since a "tree" object is a sorted list of
"filename+content", you can create a diff between two trees without
actually having to unpack two trees. Just ignore all common parts, and
your diff will look right. In other words, you can effectively (and
efficiently) tell the difference between any two random trees by O(n)
where "n" is the size of the difference, rather than the size of the
tree.

Side note 2 on trees: since the name of a "blob" depends entirely and
exclusively on its contents (ie there are no names or permissions
involved), you can see trivial renames or permission changes by noticing
that the blob stayed the same. However, renames with data changes need
a smarter "diff" implementation.

CHANGESET: The "changeset" object is an object that introduces the
notion of history into the picture. In contrast to the other objects,
it doesn't just describe the physical state of a tree, it describes how
we got there, and why.

A "changeset" is defined by the tree-object that it results in, the
parent changesets (zero, one or more) that led up to that point, and a
comment on what happened. Again, a changeset is not trusted per se:
the contents are well-defined and "safe" due to the cryptographically
strong signatures at all levels, but there is no reason to believe that
the tree is "good" or that the merge information makes sense. The
parents do not have to actually have any relationship with the result,
for example.

Note on changesets: unlike real SCM's, changesets do not contain rename
information or file mode chane information. All of that is implicit in
the trees involved (the result tree, and the result trees of the
parents), and describing that makes no sense in this idiotic file
manager.

TRUST: The notion of "trust" is really outside the scope of "git", but
it's worth noting a few things. First off, since everything is hashed
with SHA1, you can trust that an object is intact and has not been
messed with by external sources. So the name of an object uniquely
identifies a known state - just not a state that you may want to trust.

Furthermore, since the SHA1 signature of a changeset refers to the
SHA1 signatures of the tree it is associated with and the signatures
of the parent, a single named changeset specifies uniquely a whole
set of history, with full contents. You can't later fake any step of
the way once you have the name of a changeset.

So to introduce some real trust in the system, the only thing you need
to do is to digitally sign just one special note, which includes the
name of a top-level changeset. Your digital signature shows others that
you trust that changeset, and the immutability of the history of
changesets tells others that they can trust the whole history.

In other words, you can easily validate a whole archive by just sending
out a single email that tells the people the name (SHA1 hash) of the top
changeset, and digitally sign that email using something like GPG/PGP.

In particular, you can also have a separate archive of "trust points" or
tags, which document your (and other peoples) trust. You may, of
course, archive these "certificates of trust" using "git" itself, but
it's not something "git" does for you.

Another way of saying the same thing: "git" itself only handles content
integrity, the trust has to come from outside.

Current Directory Cache (".dircache/index")

The "current directory cache" is a simple binary file, which contains an
efficient representation of a virtual directory content at some random
time. It does so by a simple array that associates a set of names,
dates, permissions and content (aka "blob") objects together. The cache
is always kept ordered by name, and names are unique at any point in
time, but the cache has no long-term meaning, and can be partially
updated at any time.

In particular, the "current directory cache" certainly does not need to
be consistent with the current directory contents, but it has two very
important attributes:

(a) it can re-generate the full state it caches (not just the directory
structure: through the "blob" object it can regenerate the data too)

As a special case, there is a clear and unambiguous one-way mapping
from a current directory cache to a "tree object", which can be
efficiently created from just the current directory cache without
actually looking at any other data. So a directory cache at any
one time uniquely specifies one and only one "tree" object (but
has additional data to make it easy to match up that tree object
with what has happened in the directory)


and

(b) it has efficient methods for finding inconsistencies between that
cached state ("tree object waiting to be instantiated") and the
current state.

Those are the two ONLY things that the directory cache does. It's a
cache, and the normal operation is to re-generate it completely from a
known tree object, or update/compare it with a live tree that is being
developed. If you blow the directory cache away entirely, you haven't
lost any information as long as you have the name of the tree that it
described.

(But directory caches can also have real information in them: in
particular, they can have the representation of an intermediate tree
that has not yet been instantiated. So they do have meaning and usage
outside of caching - in one sense you can think of the current directory
cache as being the "work in progress" towards a tree commit).

Twórca

w Programowanie

19piorunów

W końcu, po około pół roku wytężonej pracy (i odpoczynku), mogę przedstawić nową wersję Czkawki/Krokieta/Cedinii 12.0 do wyszukiwania duplikatów, podobnych obrazów, wideo i wielu innych dziwnych rzeczy.

Ponieważ mój poprzedni post dotyczący problemów z dystrybucją aplikacji na Androida do szerszego grona odbiorców spotkał się z taktownym milczeniem, zostałem zmuszony do wydania aplikacji bez publikacji w zewnętrznych sklepach.

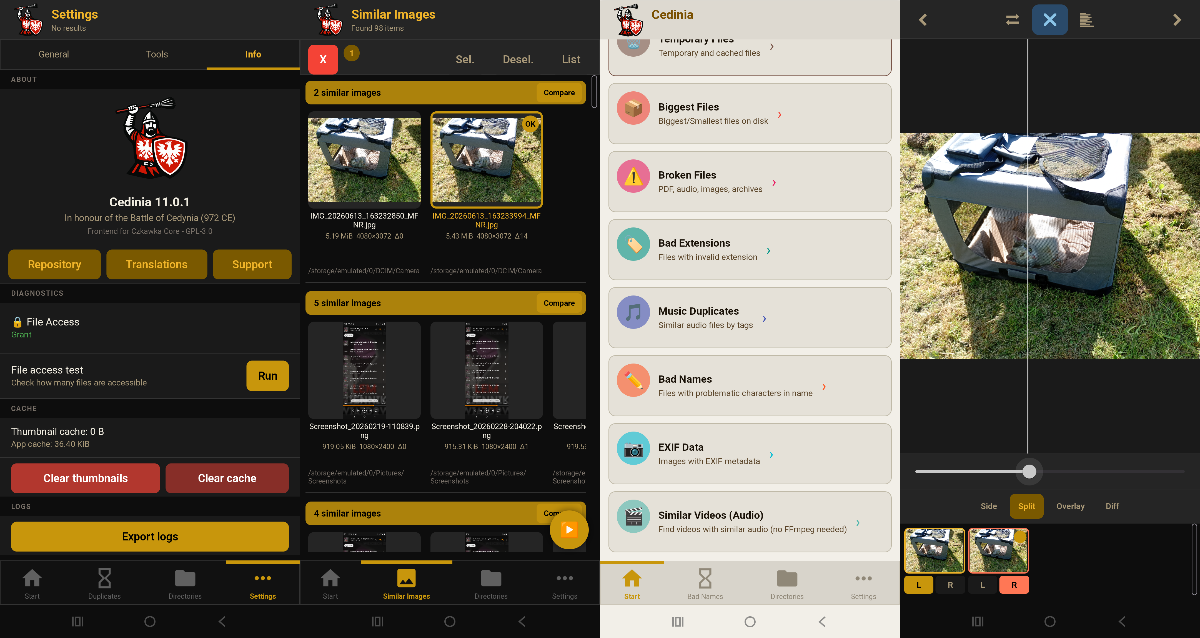
Zapewne rzuciła się wam w oczy nowa, dość bezsensowna (choć zapewne swojsko brzmiąca) nazwa - Cedinia. Jest to nowa aplikacja na Androida, instalowana z pliku APK (ponieważ nie znalazłem innej sensownej metody dystrybucji). Funkcjonalnie oferuje niemal wszystkie narzędzia dostępne w Krokiet, ale jej interfejs został dostosowany do ekranów dotykowych (testowana była jednak tylko na jednym moim telefonie, więc na innych urządzeniach mogą wystąpić problemy z UI).

Co do wersji gtk, to porzuciłem jej rozwój, bo przez długi czas sprawiała problemy - od braku uruchamiania się u części użytkowników, przez crashe przy wklejaniu, po problemy ze skalowaniem interfejsu. Dzięki temu na Windowsie pozostanie dystrybowana jedna binarka exe, zamiast paczki zip z wieloma zależnymi dllkami wymaganymi przez GTK.

Jak w każdej wersji, pojawiło się też kilka nowości tj. porównywarka obrazów, menu kontekstowe, szybka (choć mniej dokładna) weryfikacja uszkodzonych plików z użyciem ffprobe, nowe okno zaznaczania elementów, osobne przyciski do trwałego usuwania oraz przenoszenia do kosza czy także redukcja szumów w module optymalizacji wideo (opartym o ffmpeg).

Artykuł na medium, gdyby ktoś szerzej chciał o nowej wersji przeczytać - https://medium.com/@qarmin/krokiet-czkawka-12-0-c5dad2116793

Repozytorium — https://github.com/qarmin/czkawka

Pliki do pobrania wraz z listą zmian — https://github.com/qarmin/czkawka/releases

Licencja — MIT/GPL w zależności od programu (czyli w skrócie za darmo)


Osobistość0piorunów

Jakby kogoś ciekawiło:

LLM says:

W tym kontekście Krokiet/Czkawka to nie jedzenie ani odruch, tylko program do sprzątania plików.
Chodzi o aplikację autora qarmin, która służy m.in. do znajdowania:
duplikatów plików,
pustych folderów,
podobnych obrazów,
podobnych filmów / muzyki,
uszkodzonych plików,
plików tymczasowych i innych śmieci na dysku.

Brzmi ciekawie, może się kiedyś przydać. Chociaż zazwyczaj (Ubuntu) robiłem to jakimś skryptem w bashu.

Pokaż więcej komentarzy (3)