


tokensaveDebiutant
10piorunówZmierzyłem, ile tokenów „zjada” polski w modelach AI. Ten sam prompt o identycznym znaczeniu:
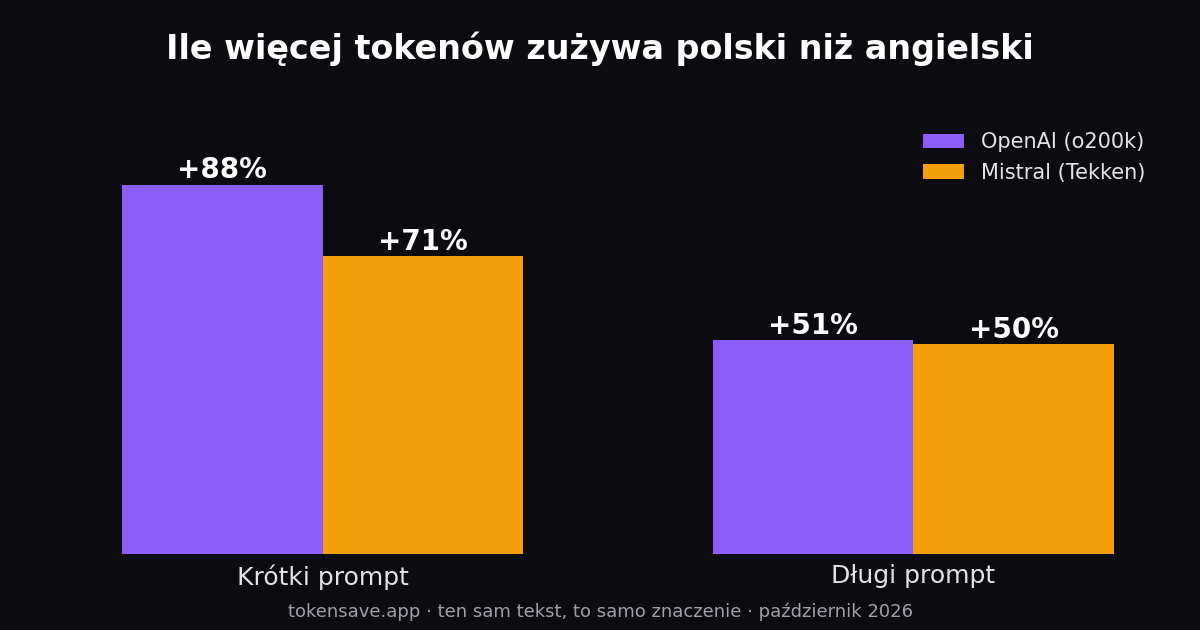
krótki (2 zdania): 34 tokeny po angielsku vs 64 po polsku (+88%*)
długi (~100 słów): 110 vs 166 (+51%*)
U Mistrala bardzo podobnie (+71% / +50%), więc „europejski” model nie pomaga. Winne są końcówki fleksyjne: „potwierdzenie” to dla tokenizera pot|wier|d|zenie, „zaproponuj” to zap|ro|pon|uj, a angielskie „invoice” czy „polite” to jeden token.
W praktyce w API płacimy za ten sam tekst nawet prawie 2× więcej, a w ChatGPT Plus / Claude Pro limit kończy się szybciej.
Trik: piszcie dłuższe instrukcje po angielsku i dodajcie na końcu „Reply in Polish”. Odpowiedź dalej przychodzi po polsku, a wejście jest krótsze o 31–41%.
Szczegóły i wykres: tokensave.app/pl/blog/ile-kosztuje-prompt-po-polsku
 jakibytuloginGruba ryba3piorunów
Wziąć darmowy model i napisać instrukcję po polsku, żeby przetłumaczyć na angielski i wynik wkleić do właściwego - taką mam koncepcję xD
 CatharsisOsobistość0piorunów
@jakibytulogin 300 IQ
 LondoMollariFanatyk0piorunów
@Catharsis @jakibytulogin Najlepiej pl -> darmowy model -> en -> właściwy model -> en -> darmowy model -> pl
Tak, aby mieć trzy poziomy halucynacji jeden nad drugim. ( ͡° ͜ʖ ͡°)
 dziad_saksonskiOsobistość0piorunów
@tokensave chodzi o tzw. Rozumienie względne.