


Wpis użytkownika Amebcio w AI

AmebcioFenomen
7piorunówCiekawa sprawa: Pojawił się nowy silnik do najnowszego modelu Qwen3.8-flash-next.
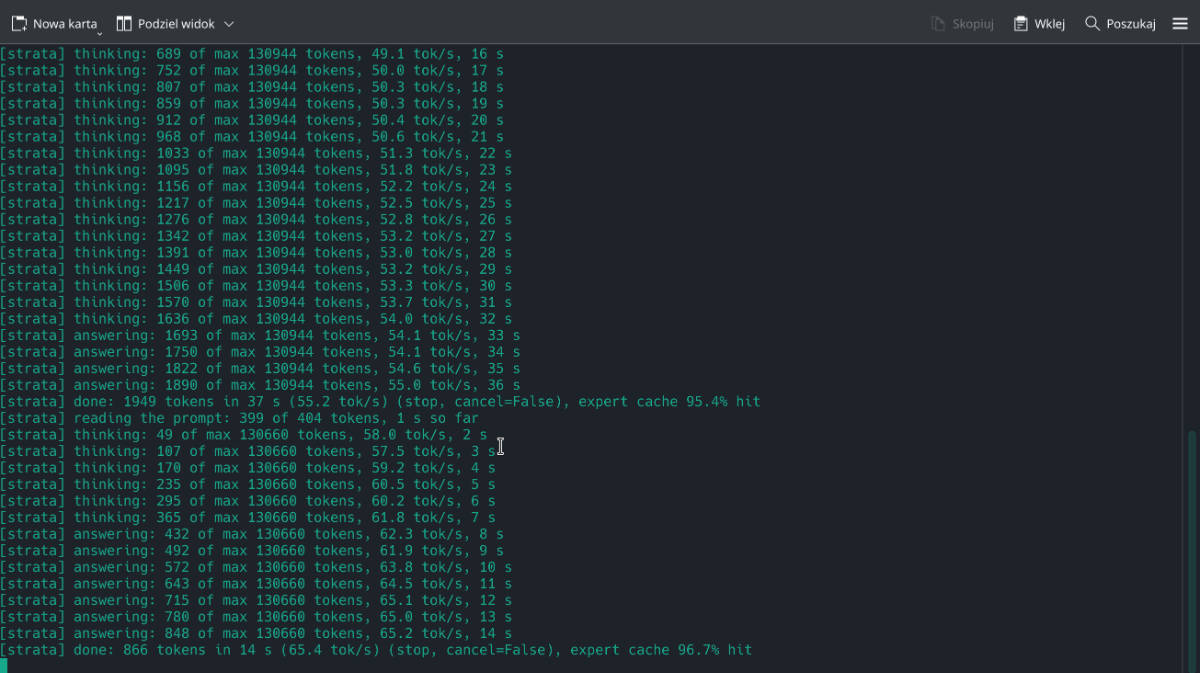
Strata, bo taką nazwę nosi ten silnik ma zaskakująco niskie wymagania:
W miarę nowe 12GB GPU na PCIEx16, 64GB RAM, szybki SSD
I teraz bomba: Ten model ma 120 miliardów parametrów. Ponieważ to MoE (mixture of experts), typ który rozwija ten silnik wrzucił najczęściej używanych ekspertów do GPU, a resztę do RAMu, do tego jest dodatkowy model przewidujący trzy kolejne słowa do przodu - silnik ładuje ekspertów do GPU z wyprzedzeniem. dzięki czemu model działa szybko. Mówimy tutaj o ~40tok/s.
Na Screenie mocno wykastrowana wersja modelu zmieszczona na styk w 24GB GPU i 32GB RAM
EDIT: Ważna sprawa, traktujcie to jako wczesną betę. Koleś nie dokończył jeszcze obsługi API zgodnego z OpenAI, więc na razie to jest zabawka a nie praktyczne narzędzie.
Komentarze (4)
 GitHubOsobistość0piorunów
Te 130k kontekstu to rozumiem zarówno w VRAM jak i RAM?
GitHubOsobistość0piorunów@Amebcio najszybciej na windows możesz sprawdzić to tak:
1. Uruchom menadżer zadań
2. Uruchom model z jakimś bardzo małym kontekstem 5-20k
3. Sprawdź jak podczas uruchamiania modelu wygląda zużycie RAM i VRAM
Jest zasada, że model w pełni odpalany na szybszej pamięci np. GDDR6 w GPU będzie działać szybciej niż model który "wycieka" z GDDR6 do np. DRR5 lub DDR4.
(Model w pełni odpalony = sam model + pamięć na kontekst jest w tym samym rodzaju pamięci)
Można też sprawdzić czy karta graficzna współdzieli jakąś pamięć z RAM (na obrazku: shared memory uwagę) co oznacza właśnie przepełnienie pamięci w GPU i wyciekanie modelu do RAM.
 AmebcioFenomen0piorunów
@GitHub Prawdę mówiąc nie wiem jak to jest podzielone. Gdybym miał zgadywać to zgadywałbym że kontekst siedzi w RAM
 ostrynacienkimGruba ryba2piorunów
nono